 실제 실행 화면 아님·보도 인용·별도 허가 취득 아님
AI가 코드를 만든 뒤 ‘테스트를 통과했으니 안전하다’고 말하면 어디까지 믿을 수 있을까. 앤트로픽과 Theorem이22일 공개한 연구는 다른 경로를 제시한다. 클로드가 정해진 안전 조건의 수학적 증명을 쓰고, 별도 도구인 Rocq가 그 증명을 검사하는 방식이다. AI의 자신감 있는 답변을 그대로 검증 결과로 삼는 것은 아니다.
많이 시도하는 테스트와 모든 입력을 다루는 명제
퍼징은 입력을 무작위로 만들거나 바꿔 실행하면서 실패를 찾는다. 많이 돌려도 아직 시도하지 않은 입력은 남는다. 연구진은 기존 OSS-Fuzz 테스트를 컴파일한 RISC-V 실행파일에 대해, 제한 안의 어떤 입력에서도 정해진 오류가 나지 않는다는 명제로 옮겼다. 클로드는 그 명제에 맞는 증명을 작성한다.
연구 발표는123개 오픈소스 라이브러리의239개 진입점에서64MB 미만 입력에 대한 결과를 보고했다. 그러나 단일 스레드·정적 RISC-V 실행파일·고정 메모리 예산·모델링된 Linux 환경이라는 가정이 붙는다. 일반 사용자의 x86·ARM 기계나 다른 빌드까지 같은 보장이 자동으로 옮겨지는 것은 아니다.
연구 전체와 공개된 증명 묶음도 다르다
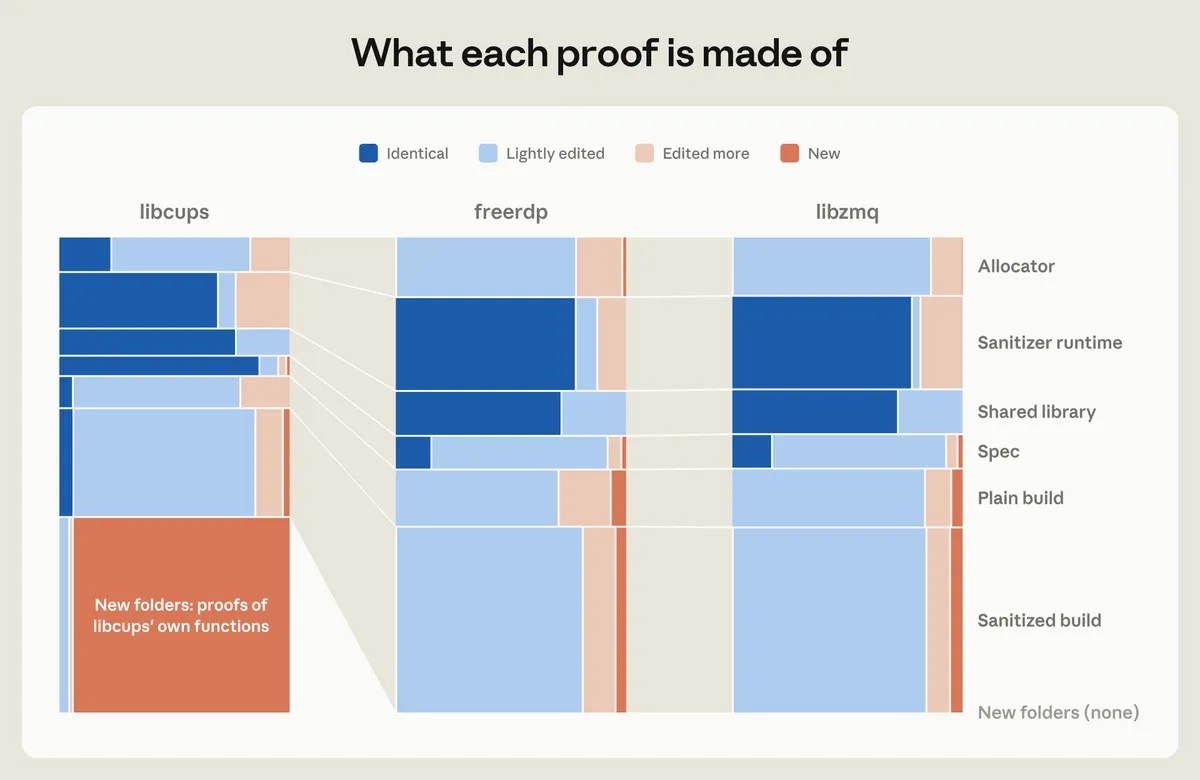
실제 공개 저장소의 현재 안내는25개 라이브러리·60개 진입점의 증명을 담고 있다고 설명한다. 연구 전체 수치와 공개된 일부를 혼동하면 안 된다. 저장소는 증명이 특정 바이너리와 해당 진입점이 도달하는 코드에 관한 것이며, 라이브러리 전체의 올바른 결과나 메모리 누수까지 보장하지 않는다고 명시한다. 이번 공개 증명은 끝나지 않는 실행까지 배제한 것도 아니다.
외부 검사기가 있다는 것만으로 모든 신뢰 문제가 사라지지도 않는다. 무엇을 증명하라는 명제를 세웠는지, 실제 CPU와 운영체제를 수학적으로 옮긴 모델이 현실과 맞는지, 검사기 자체가 정확한지가 여전히 중요하다. 독자가 읽어야 할 것은 ‘AI가 버그를 없앴다’는 한 문장이 아니라 무엇을 어떤 조건에서 증명했는지다.
공동 연구사 Theorem은 자격을 갖춘 오픈소스 프로젝트에 검증을 제공하는 OSS Verify도 안내한다. 프로젝트 핵심 관리자가 신청하고 개별 심사를 거치는 경로이지 모든 코드가 즉시 무료 검증된다는 뜻은 아니다. 이번 취재는 공식 연구와 공개 저장소의 범위를 대조했으며, 대규모 증명이나 검사 환경을 내려받아 독립 재실행한 것은 아니다.
출처로 확인한 내용
5건
클로드가 쓴 형식 증명을 Rocq가 명제에 맞춰 검사하는 연구다.

연구 보고123개/239개·64MB 미만 입력에는 정적 단일스레드 RISC-V 등 조건이 붙는다.
현재 공개 증명 저장소의 실제 범위는25개 라이브러리/60개 진입점이다.

저장소는 전체 라이브러리의 정확성/모든 오류/무한실행 배제를 보장하지 않는다고 구분한다.
OSS Verify는 핵심 관리자가 신청한 자격 충족 오픈소스 프로젝트를 개별 심사한다.