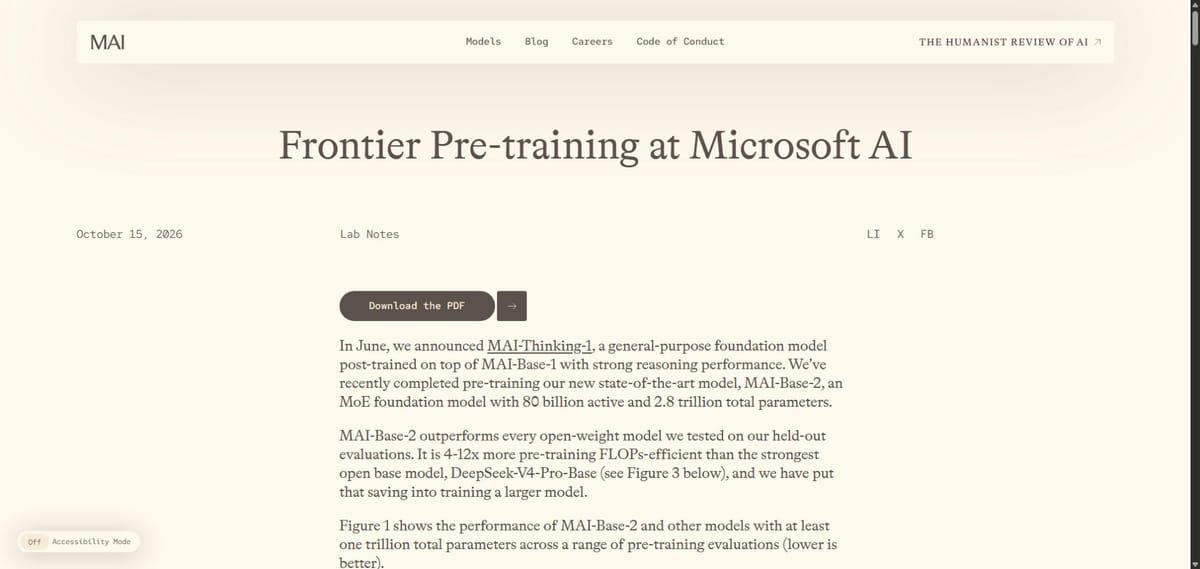
 Microsoft AI · MAI-Base-2 공식 발표 원해상도1905×904 화면 · 보도 인용·허가 취득 아님
AI 서비스를 빌려 쓰는 회사에서, 기반 모델의 데이터와 학습 방식까지 직접 설계하는 회사로 무게를 옮기는 발표다. Microsoft AI는 15일 공개한 기술 글에서 MAI-Base-2의 사전 학습을 마쳤다고 밝혔다. 새 모델은 총 2조8000억 개의 매개변수를 갖지만, 작업 때 활성화하는 부분은 800억 개인 전문가 혼합(MoE) 구조다.
모든 매개변수를 한꺼번에 쓰는 방식은 아니다
MoE는 입력에 맞는 일부 전문가를 골라 계산하는 구조다. 총규모와 활성 규모가 다른 이유다. 회사는 8~9월에 GB200 GPU 약 1만6000개로 38일 동안 학습했다고 설명했다. 큰 숫자 자체보다, 모델·데이터 처리·학습 인프라를 함께 조정해 자체 기반 모델을 확장했다는 점이 이번 발표의 핵심이다.
‘학습 효율’이 이용자 응답 속도라는 뜻은 아니다
회사는 따로 보관한 코드·질의응답·과학·수학 자료의 BPB 평가에서 시험한 공개 가중치 모델보다 낮은 값을 얻었다고 밝혔다. 비교 대상은 2026년 10월 이전에 이용 가능했던 체크포인트다. 일부는 후속 학습을 마친 모델이어서 그 차이도 주의해야 한다고 원문에 명시했다.
DeepSeek-V4-Pro-Base와 비교해 사전 학습 FLOPs 효율이 4.2~12.3배라는 수치는 자체 스케일링 법칙으로 추정한 학습 계산량 비교다. 챗봇이 그만큼 빠르게 답한다거나 이용 요금이 같은 비율로 내려갔다는 측정은 아니다. 이번 기사가 독립적으로 모델 성능을 시험한 것도 아니다.
지금은 후속 학습 중…기업용 제공을 겨냥한다
Microsoft는 다른 모델의 답을 증류하는 대신 자체 처리한 데이터를 학습에 사용했다고 설명했다. 이미지와 텍스트도 함께 사전 학습했으며, 앞으로 Foundry를 통해 신뢰하는 파트너에게 모델 가중치를 라이선스하는 방향을 제시했다. 자체 제품과 기업 고객의 요구에 맞춰 전체 기술 체계를 조정하려는 구상이다.
다만 현재 MAI-Base-2는 후속 학습을 진행 중이다. 누구나 내려받을 수 있는 가중치 공개나 일반 이용자용 새 챗봇 출시를 알린 글은 아니다. 다음 제품의 기반이 실제로 어떤 답변 능력과 이용 조건으로 이어질지는 후속 발표에서 확인할 부분이다.
출처로 확인한 내용
4건
Microsoft AI는 MAI-Base-2의 사전 학습 완료와 총2.8T·활성80B MoE 구조를 발표했다.
회사는16k GB200 GPU로8~9월38일 동안 학습했다고 밝혔다.
BPB 비교와4.2~12.3배 FLOPs 효율은 회사 자체 평가·추정이며 이용자 추론 속도 측정이 아니다.
모델은 현재 후속 학습 중이며 Foundry를 통한 파트너 가중치 라이선스 방향을 제시했다.