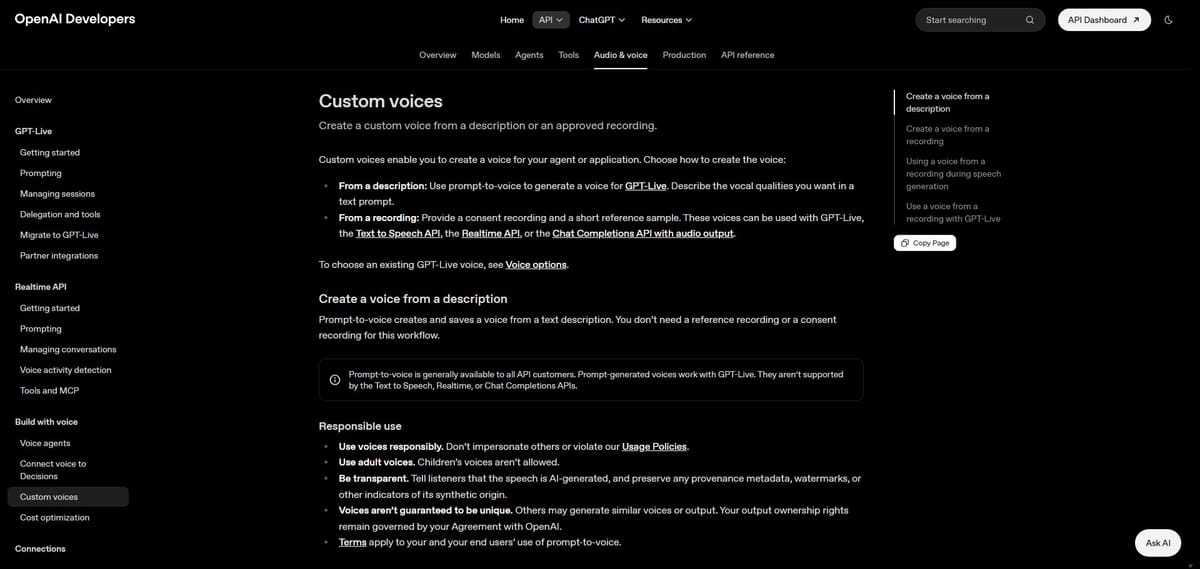
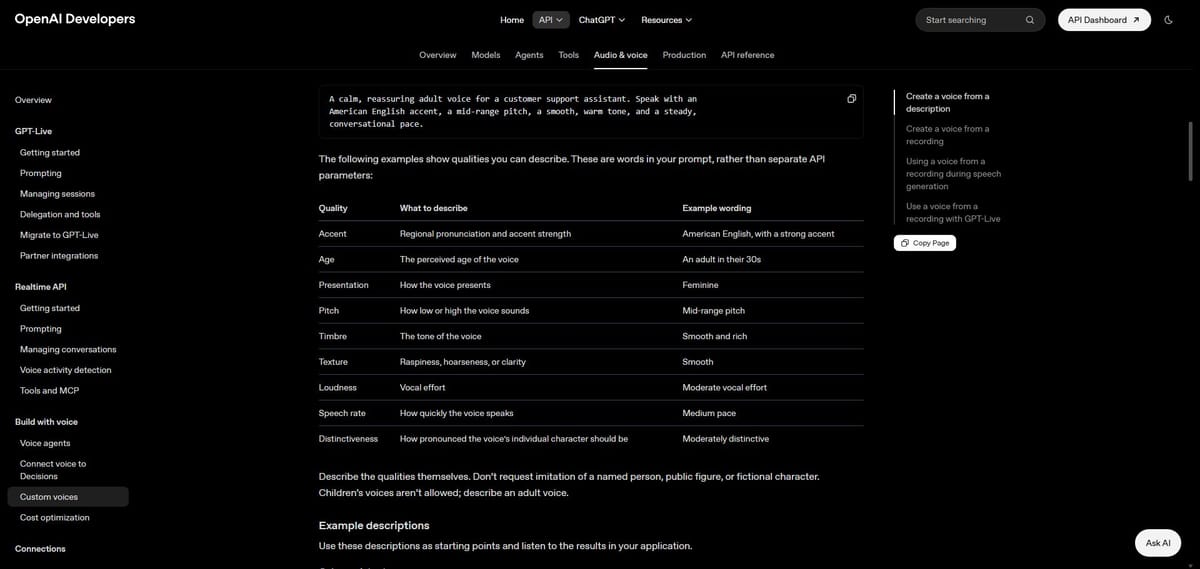
 OpenAI Developers 공식 Custom voices 문서1920×911 실제 화면 · 새 목소리를 생성한 시연 결과 아님 · 확대·합성 없음 · 보도 인용(허가 취득 아님)
‘차분한 성인 목소리, 중간보다 낮은 음역, 따뜻한 음색, 서두르지 않는 말투.’ 앱의 안내 음성을 정할 때 이런 특징을 글로 설명해 목소리를 만드는 길이 열렸다. OpenAI가16일 전체 API 고객에게 공개한 prompt-to-voice는 참고할 사람의 녹음 파일 없이 GPT-Live용 음성을 생성하고 저장하는 기능이다.
정해진 프리셋 목록에서 목소리를 고르는 것과도, 실제 인물의 녹음을 복제하는 것과도 다르다. 공식 문서는 억양·나이감·목소리 높이·음색·거친 정도·말 빠르기 같은 특징을 설명하도록 안내한다. 이 항목들이 각각의 조절 버튼이라는 뜻은 아니며, 원하는 특성을 문장 안에 적는 방식이다.
한 번 만든 목소리를 다음 대화에서도 쓴다
생성에 성공하면 음성 ID와 원래 설명문 등 정보가 반환된다. 같은 목소리를 다음 대화에서도 쓰려면 이 ID를 보관해 재사용한다. 매번 새 목소리를 만들면 조직에 저장되는 음성도 늘어난다. 설명 기반 음성은 조직당 최대100개이며, 앱이 고객을 위해 만든 음성도 같은 한도에 포함된다.
목소리를 만드는 작업은 무료지만, 실제로 말하게 하거나 미리 들어보는 GPT-Live 세션에는 일반 세션 요금이 적용된다. 만들기 응답에 음성 파일이나 무료 미리 듣기가 함께 들어오는 구조는 아니다. 현재 설명 기반 음성은 GPT-Live에서만 지원하며 Text to Speech·Realtime·Chat Completions API에 그대로 쓸 수는 없다.
실제 사람의 목소리를 재현하려는 녹음 기반 custom voice는 별도 절차다. 이쪽은 제공 대상 제한과 당사자의 동의 녹음·참조 음성 조건을 따라야 한다. 설명 기반 생성도 성인 음성을 대상으로 하며 청자에게 AI 생성 음성임을 알려야 한다. 이번 기사는 공식 문서로 기능과 적용 범위를 확인했으며, 유료 생성이나 한국어 음질 시험을 실행한 결과는 아니다.
출처로 확인한 내용
5건
prompt-to-voice는10월16일 전체 API 고객에게 일반 제공됐다.

참조·동의 녹음 없이 음성 특징 설명으로 GPT-Live용 목소리를 생성하고 저장한다.
생성한 ID와 설명문을 보관해 재사용하며 조직당 최대100개에 고객용 생성도 포함된다.
생성은 무료이나 듣기·발화 GPT-Live 세션은 일반 요금이며 TTS/Realtime/ChatCompletions는 지원하지 않는다.
성인 음성·타인/인물/캐릭터 모방 금지·AI 생성 공개 조건과 별도 녹음 기반 음성의 동의 절차를 구분한다.